Від AI-демо до надійного workflow
14.10.2026
Як я організовую AI проєкт навколо задачі клієнта
14.10.2026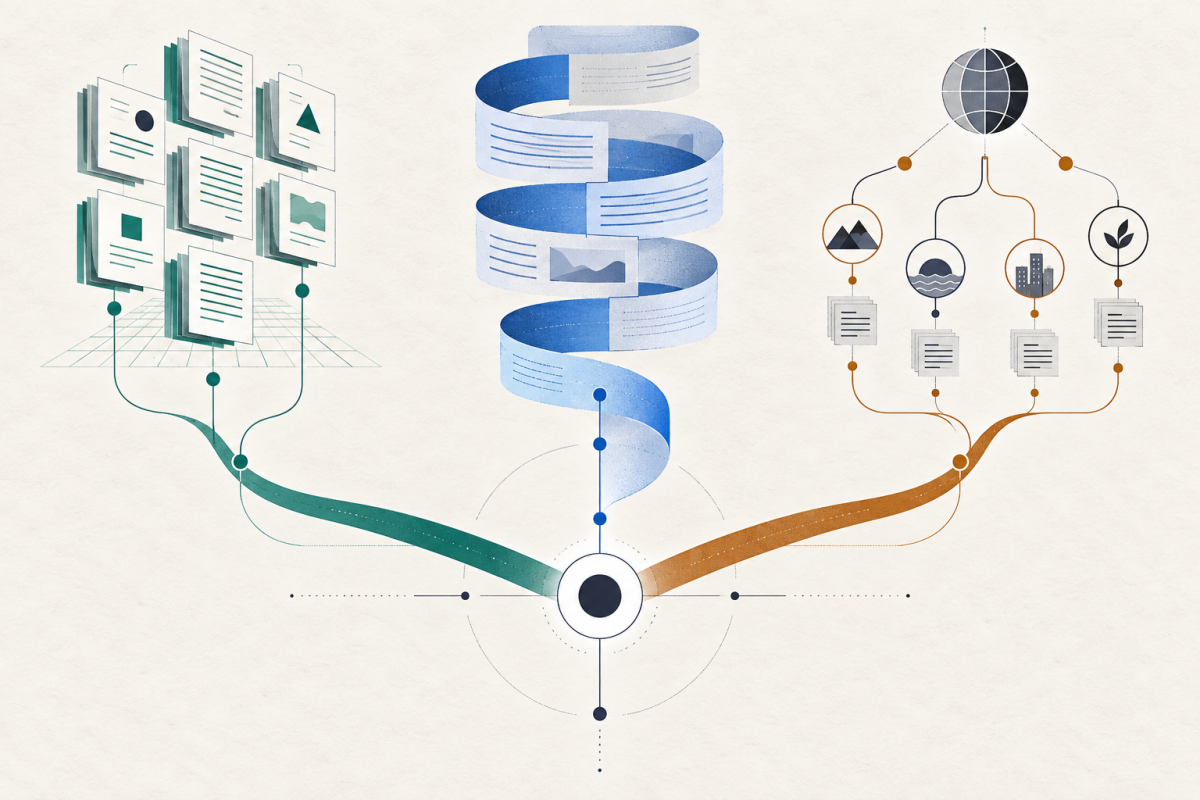
Вибір між RAG, long context і search залежить від корпусу матеріалів, запитання, вимог до актуальності, стандарту provenance, допустимої затримки та можливостей експлуатації системи. Це різні способи знаходити й подавати інформацію людині або моделі, а не взаємозамінні назви продуктів.
Почніть із найпростішої системи, яка здатна надійно відповісти на реальне запитання.
RAG, long context і search: як працює кожен підхід
Search повертає документи або фрагменти, що відповідають запиту. Часто це найкраща відправна точка, коли людина може переглянути результати, важливі точні терміни або корпус матеріалів часто змінюється.
Long context передає відібраний пакет доказових матеріалів безпосередньо на вхід моделі. Це може бути простим і ефективним рішенням для обмеженого набору документів, але вартість, затримка, увага моделі та межі контексту все одно мають значення.
Retrieval-augmented generation (RAG) знаходить відібрані матеріали й пропонує моделі сформувати відповідь на їхній основі. Цей підхід дає змогу масштабувати повторювані відповіді на запитання за більшим корпусом, але додає обов’язки з ingestion, chunking, індексації, retrieval, посилань на джерела, оцінювання й оновлення.
1. Почніть із рішення та користувача
Якщо користувачу потрібні документи для перегляду, search може бути достатньо. Якщо потрібне узагальнення невеликого контрольованого пакета доказових матеріалів, long context може бути простішим. Якщо багато користувачів регулярно ставлять різні запитання до більшого корпусу з визначеними правилами керування, RAG може виправдати себе.
Не обирайте архітектуру лише тому, що вона модна. Визначте завдання, очікуваний результат, вимоги до доказів і допустимі помилки.
2. Врахуйте актуальність
Search може працювати з актуальним індексом, але лише за належного оновлення цього індексу. Актуальність long context визначає пакет доказових матеріалів, зібраний для запиту. Актуальність RAG залежить від його ingestion- і retrieval-пайплайну.
Якщо актуальність критична, фіксуйте часові позначки джерел і показуйте їх у результаті. Навіть добре сформульована відповідь на основі застарілих даних залишається застарілою.
3. Зробіть provenance обов’язковою вимогою
Search зазвичай показує джерела результатів, хоча релевантність усе одно потрібно оцінювати. Системи long context можуть посилатися на надані матеріали, якщо фрагменти мають сталі ідентифікатори. RAG потребує цілеспрямованого зіставлення згенерованих тверджень із доказами, отриманими через retrieval.
Якщо робочий процес не може показати, яке джерело підтверджує суттєве твердження, згенерований результат слід вважати підказкою для подальшої перевірки, а не перевіреною відповіддю. Матеріал «Як побудувати AI Knowledge System із provenance» описує модель записів, яка це підтримує.
4. Узгодьте метод зі структурою даних
Точні ідентифікатори, дати, суми, статуси та зв’язки можуть потребувати структурованих запитів, а не semantic retrieval. Search добре працює з точними формулюваннями й фільтрами. Semantic retrieval допомагає знаходити концептуально схожі матеріали, але може пропустити критично важливий точний збіг або повернути правдоподібний сусідній результат.
Багато корисних систем поєднують структуровані фільтри із search або semantic retrieval. Такий гібрид виправданий лише тоді, коли кожен компонент має чітку роль.
5. Врахуйте масштаб і зміни
Long context привабливий, коли набір доказових матеріалів достатньо малий, щоб його можна було зібрати й перевірити. Зі зростанням корпусу передавати все стає неефективно, а релевантні матеріали буває складніше відокремити.
RAG працює з більшими корпусами, відбираючи підмножину матеріалів, але сам відбір стає новою точкою можливого збою. Search може добре масштабуватися, проте результати все одно має інтерпретувати людина або наступний етап узагальнення.
6. Оцініть загальну вартість і затримку
Враховуйте ingestion, індексацію, зберігання, retrieval, вхідні дані моделі, генерацію, перевірку, моніторинг і супровід. Для long context найбільшу частку витрат можуть становити великі вхідні дані. Для RAG складність пайплайну та оцінювання додають витрат навіть тоді, коли кожна відповідь використовує менше токенів. Для search основною витратою може бути час перевіряльника.
У цій статті немає тверджень про поточні ціни чи швидкість. Вимірюйте показники конкретної конфігурації-кандидата на корпусі й наборі запитів із зафіксованою датою.
7. Перевірте типові збої
Для search перевіряйте пропущені точні збіги, погане ранжування, помилки фільтрів і застарілу індексацію. Для long context — пропущені докази, суперечливі фрагменти, збої уваги та завеликі вхідні дані. Для RAG — прогалини ingestion, невдалі межі chunking, пропуски retrieval, оманливі сусідні результати, невідповідність посилань і узагальнення без доказової опори.
Додайте запитання, на які правильна відповідь — «не знайдено», і запитання із суперечливими доказами. Система, яка завжди дає впевнену відповідь, не обов’язково корисна.
8. Використовуйте відтворюваний набір для оцінювання
Створіть репрезентативний корпус і набір запитів з очікуваними доказами, а не лише очікуваними формулюваннями. Зафіксуйте модель, інструменти, конфігурацію, версію корпусу й дату. Оцінюйте retrieval окремо від генерації, щоб вдала підсумкова фраза не приховала збою retrieval.
Корисними показниками можуть бути evidence recall, source precision, частка непідтверджених тверджень, корисність відповіді, затримка, вартість прийнятого результату та розбіжності між перевіряльниками. Обирайте показники відповідно до завдання.
9. Віддавайте перевагу простим гібридам
Практичний гібрид може використовувати структуровані фільтри для звуження області, search — для знаходження точних фрагментів, а модель — для узагальнення лише відібраних доказів. Інший варіант — search за замовчуванням і long context для обмеженого пакета матеріалів на перевірку.
Не додавайте компоненти без доказів того, що кожен із них усуває реальну помилку. Складність збільшує кількість станів для моніторингу й способів втратити provenance.
Дерево рішень
- Користувачу насамперед потрібні документи або фрагменти для перегляду? Почніть із search.
- Пакет доказових матеріалів невеликий, обмежений і зібраний для одного завдання? Протестуйте long context.
- Корпус більший, до нього регулярно звертаються й потрібне узагальнення? Оцініть RAG.
- Точні структуровані поля критично важливі? Додайте structured retrieval або фільтри.
- Кожне суттєве твердження має бути простежуваним до джерела? Зробіть ідентифікатори джерел і перевірку посилань обов’язковими для будь-якого підходу.
- Запропонована система складніша, ніж того потребує виміряна проблема? Поверніться до простішого варіанта.
У виборі між RAG, long context і search немає незмінного переможця. Розмір корпусу, поведінка моделей, витрати й інструменти змінюються. Зберігайте набір для оцінювання й переглядайте вибір, коли ці умови суттєво змінюються.
Першоджерела
Lewis et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Liu et al.: Lost in the Middle: How Language Models Use Long Contexts
Читайте також: огляди й дослідження, технологічні основи та AI-системи.