Як моя AI OS досліджує рішення про маркетингові ресурси
14.10.2026
Dell Pro Max with GB10 4 TB: підтримка й сервіс навколо тієї самої платформи
14.10.2026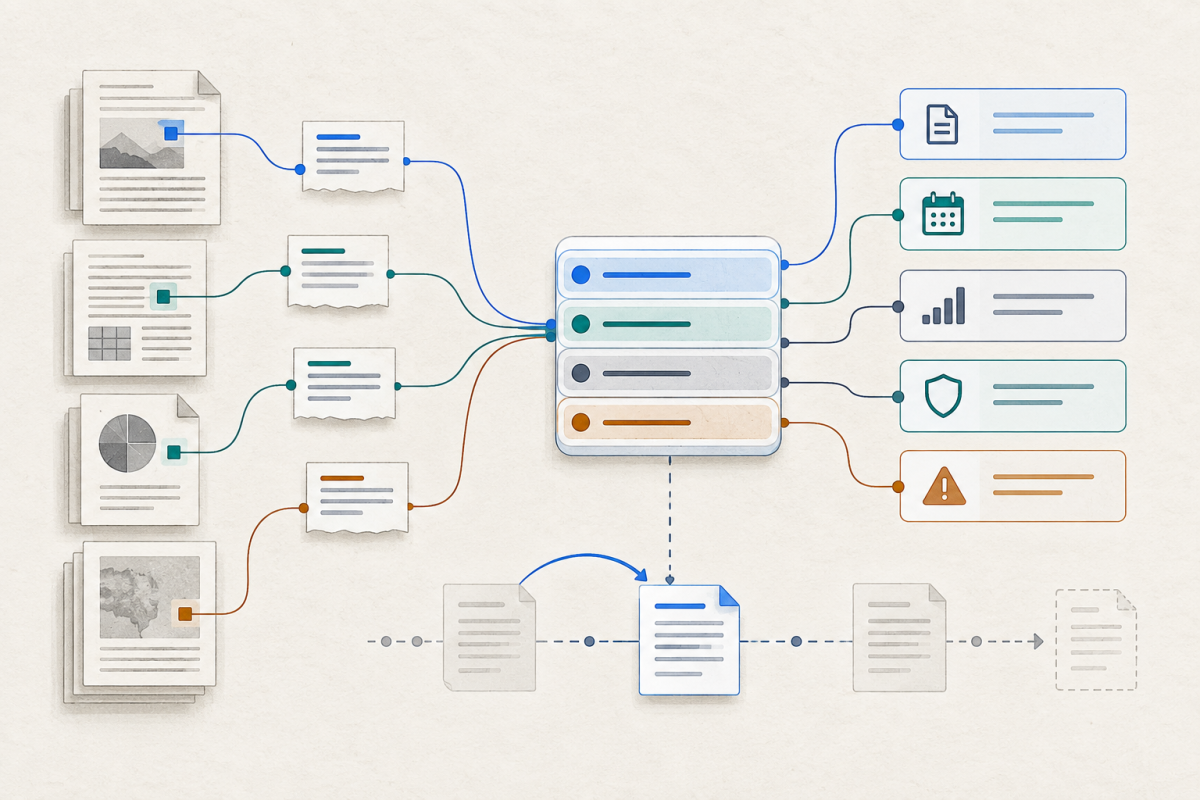
Система знань для AI стає менш надійною, коли зберігає речення, але втрачає відомості про те, звідки воно взялося, коли було актуальним, хто може його бачити та чи воно підтверджене, чи лише запропоноване.
Provenance — структура, що зберігає ці зв’язки. Вона дає змогу наступному читачеві або retrieval-системі відповісти не лише на запитання «що сказано в записі?», а й «чому я можу покладатися на нього в цьому контексті?»
Починайте з тверджень, а не з документів
Документи залишаються важливими доказами, але часто вони надто великі й неоднозначні, щоб бути єдиною одиницею знань. Виділяйте суттєві твердження в записи, які можна перевірити незалежно, зберігаючи посилання на відповідний уривок джерела.
Корисне твердження достатньо конкретне, щоб його можна було підтвердити або спростувати. «Проєкт у доброму стані» — не довготривале твердження. «Staging-реліз пройшов затверджені перевірки прийняття у зафіксовану дату» можна оцінити, якщо збережено перевірки та запис-джерело.
Використовуйте повний запис доказів
Для кожного суттєвого твердження зберігайте:
- Факт або твердження: точне формулювання.
- Джерело: документ, URL, dataset, observation або запис рішення.
- Дата джерела: коли доказ створено або зафіксовано.
- Рівень упевненості: наскільки переконливо доказ підтверджує твердження.
- Контекст: де твердження застосовне, а де може не бути застосовним.
- Приватність: хто може отримати доступ або опублікувати запис.
- Статус: підтверджено, виведено з наявних даних, невідомо або суперечність.
- Повноваження: хто може вирішувати або погоджувати використання запису.
Ці поля не дають сплутати рівень упевненості зі статусом. Запис може з високою впевненістю засвідчувати суперечність між двома джерелами, тоді як відповідь на основне запитання залишається невизначеною.
Розділяйте дату джерела й дату перевірки
Дата створення джерела — не дата останньої перевірки його застосовності. Зберігайте обидві. Для тем, які часто змінюються, додавайте строк актуальності або умову перегляду.
Не перезаписуйте старі докази непомітно. Якщо нове джерело замінює попереднє, зберігайте цей зв’язок, щоб наступні читачі могли зрозуміти причину зміни висновку.
Приватність має керувати retrieval
Приватність — не просто позначка, яку показують після retrieval. Вона має визначати, які записи потрапляють до індексу, які інструменти можуть їх запитувати, які outputs можуть залишати систему та хто може погодити публікацію.
Для чутливих колекцій використовуйте явні allow-lists. Мінімізуйте копіювання вмісту. Не додавайте credentials, дані сесій, приватну інформацію клієнтів або зайві персональні дані до загального індексу знань.
Зберігайте суперечності, а не згладжуйте їх
Коли надійні джерела суперечать одне одному, створюйте запис конфлікту з посиланнями на конкуруючі твердження. Зазначайте, які докази можуть усунути суперечність і хто має повноваження ухвалити рішення.
Summarization може приховати розбіжність, перетворивши її на гладке формулювання. Retrieval має показувати релевантну суперечність, а не без належних повноважень обирати переможця.
Відокремлюйте виправлення від видалення
Виправлення має додавати новий стан і пов’язувати його із записом, який змінюється. Видалення доречне для даних, які не слід було зберігати, але погано замінює audit trail, якщо сама історія законна й корисна.
Фіксуйте, хто погодив виправлення, коли воно набуло чинності та які похідні представлення або індекси потрібно оновити.
Проєктуйте retrieval під конкретне запитання
Не кожне завдання потребує semantic retrieval. Точні ідентифікатори, дати, статуси та повноваження можуть краще оброблятися структурованими фільтрами або пошуком. Long context може бути достатнім для невеликого стабільного набору доказів. RAG може допомогти, якщо великий корпус потрібно регулярно використовувати для retrieval.
Обирайте найпростіший підхід, який зберігає потрібні докази. Компроміси пояснено в матеріалі «RAG, Long Context чи Search».
Робіть посилання на докази доступними для перевірки
Посилання має вести до доказу, який людина може переглянути, бажано — до відповідного уривка або структурованого запису. Перелік файлів наприкінці відповіді слабший за прямий зв’язок між кожним важливим твердженням і його джерелом.
Якщо джерело не можна розкрити, зазначте, що твердження спирається на доказ з обмеженим доступом, і відповідно обмежте output. Не вигадуйте публічного посилання.
Зберігайте погодження людини на межі публікації
Система може допомагати знаходити, порівнювати джерела або готувати текст на основі доказів. Відповідальна людина має погодити суттєві твердження до того, як вони стануть публічними або спричинять дію з наслідками.
Погодження має стосуватися точної версії твердження й output. Загальне погодження колекції джерел не погоджує кожне майбутнє зведення, створене на її основі.
Створюйте export views, а не дублікати істини
Різним аудиторіям можуть бути потрібні публічне зведення, внутрішнє робоче представлення та технічне audit view. За можливості формуйте їх із тих самих керованих записів. Не підтримуйте незалежні копії, які можуть розійтися без видимого узгодження.
Мінімальний Source & Claim Ledger
Практичний ledger можна почати з таких колонок:
claim_id, claim, source_id, source_date, observed_or_reviewed_date, confidence, context, privacy, status, authority, supersedes, review_condition
Перш ніж додавати автоматизацію, перевірте, чи може рецензент простежити суттєвий output до джерела, побачити суперечності, визначити обмеження приватності та зрозуміти, хто може погодити зміну.
Мета не в тому, щоб зібрати все. Вона в тому, щоб зберегти достатньо доказів і повноважень, аби знання залишалися корисними після втрати початкового контексту.
Пов’язані матеріали: workflows, технологічні основи та використання AI й виправлення.