API, JSON і webhooks: простежмо одну подію між двома застосунками
18.10.2026
Час очікування запиту минув. Чи надсилати його знову?
18.10.2026
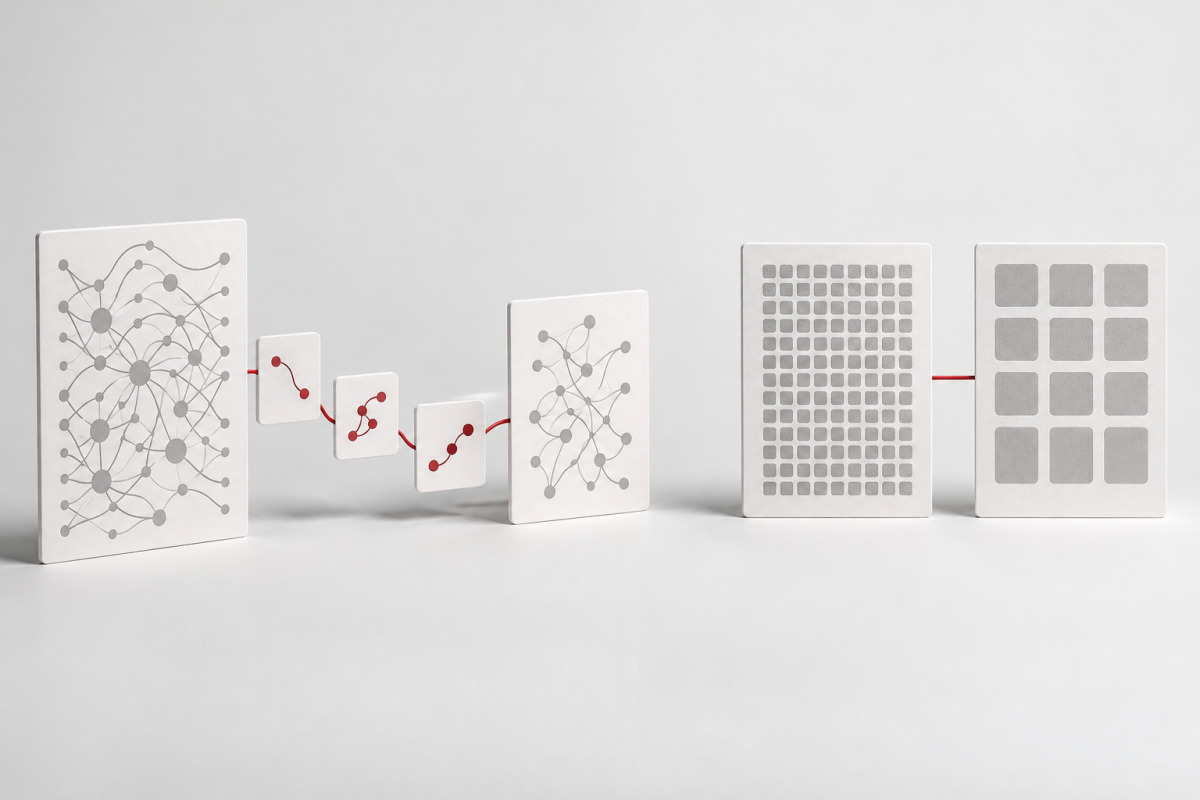
Два підходи, один план порівняння. Ілюстрацію створено за допомогою AI; реальний експеримент чи його результати не зображено.
Після зміни робочий процес швидше створює чернетки. Чи став він кращим? Це залежить від їхнього призначення. Коротше очікування, придатний результат і цінний бізнес-результат відповідають на різні питання. Перш ніж будувати графік, запишіть, яке рішення має підтримати вимірювання.
Почніть із потрібного результату
Уявімо команду, яка готує редакційні брифи з опорою на джерела. Вона пропонує додати до шаблону чернетки контрольний список джерел. Мета — надавати брифи, які перевіряльник може прийняти без виправлення доказової бази. Це вигадана пропозиція: жодних брифів не розподіляли, експерименту не проводили й покращення не спостерігали.
Метрика — визначена кількісна міра. У цьому прикладі показник, обраний для оцінювання мети, назвемо key performance indicator, або KPI. Обраний KPI — частка придатних до оцінювання брифів, прийнятих без виправлення доказової бази. Час підготовки залишається окремою метрикою й не замінює питання прийняття.
Вступ OpenTelemetry до observability описує метрики як числові агрегації за часом, зокрема частоту помилок і запитів. Такі операційні сигнали допомагають пояснювати поведінку системи. Система може бути доступною, але давати неправильний результат. Так само швидка підготовка чернеток може створювати брифи, що потребують виправлення доказів; вимірювання лише швидкості залишає нашу мету без відповіді.
Визначте для KPI правила вимірювання
У вигаданій пропозиції «прийнято без виправлення доказової бази» означає, що перевіряльник приймає бриф без заміни непідтвердженого фактичного твердження чи виправлення невідповідності джерела. Стилістичні правки не належать до таких виправлень. Результат записується для призначеного брифу, а не так, ніби кожна його редакція — ще один успішний бриф.
Запропонована формула: прийняті без виправлення доказової бази придатні брифи ÷ усі призначені придатні брифи × 100. Одиниця — відсоток призначених брифів. Кожен бриф враховується в чисельнику й знаменнику не більш ніж один раз. За нульового знаменника відсоток не визначений; це не нульова частка прийняття.
| Поле правил | Запропоноване правило для вигаданого процесу |
|---|---|
| Придатна робота | Брифи з опорою на джерела, що відповідають однаковим погодженим вхідним вимогам |
| Знаменник | Усі придатні брифи, призначені відповідному варіанту, включно з невдалими |
| Успіх | Прийняття без виправлення доказової бази до погодженого моменту завершення спостереження |
| Незавершена робота | Залишати у знаменнику; окремо фіксувати очікування, невдачу або відсутність результату |
| Вікно порівняння | Однаковий час спостереження за призначеними брифами; межу визначити до початку |
| Додаткові перевірки | Відстежувати час виконання, причини виправлення доказів і відсутні записи перевірок |
Кінцевий строк спостереження залишається проєктним рішенням, а не прихованим припущенням. За цією пропозицією бриф, який на момент відсікання ще очікує рішення, не є успіхом, навіть якщо його приймуть пізніше. Обидва варіанти мають застосовувати це правило. Команді слід зберігати первинні позначки результатів, щоб відрізняти затримку від проблеми з доказами.
Зберігайте зіставність базової лінії
Baseline — точка відліку, з якою порівнюють результат. У рекомендаціях Google щодо впровадження моделі радять починати з простого та використовувати просту модель як baseline перед ускладненням. Для нашого питання про процес корисною точкою відліку є чинний шаблон. Новіший шаблон не слід наперед вважати кращим.
Для вигаданої історичної базової лінії команді потрібні записи з однаковим визначенням прийняття, придатної роботи, знаменника й правила спостереження. Якщо старі записи враховують лише завершені брифи, їх не можна непомітно порівнювати з усіма призначеними. Потрібно узгодити визначення або прямо зазначити, що історичний відсоток недоступний.
Навіть зіставне порівняння «до і після» описує зміну в часі, але саме по собі не встановлює причини. Простіші брифи, інший перевіряльник або спокійніший тиждень — альтернативні пояснення цього уявного випадку. Для запропонованого списку потрібне порівняння, спроєктоване саме під причинне питання.
Порівнюйте варіанти через спланований A/B-тест
A/B-тест порівнює варіанти за наперед визначеними результатами, зазвичай випадково розподіляючи придатні одиниці. Рекомендації Microsoft Research щодо підготовки експерименту наголошують на чіткій гіпотезі, доречних метриках і придатній одиниці рандомізації. Рандомізація підтримує причинне порівняння за коректного дизайну, але не гарантує його. Спільні люди чи ресурси можуть дозволити одному варіанту впливати на інший. Аналіз має враховувати одиницю розподілу та залежності.
Планування вибірки залежить від ефекту, який варто виявляти, мінливості результату, придатних одиниць і прийнятної невизначеності. Повторні спостереження в межах однієї призначеної одиниці не стають автоматично незалежними вибірковими одиницями. Вікно спостереження має дозволити потрібним результатам проявитися. Немає універсальної кількості брифів чи тривалості тесту, що зробила б цю пропозицію надійною.
Тут варіант A залишає чинний шаблон, а B додає контрольний список. Бриф — лише попередньо запропонована одиниця розподілу: експеримент не готовий до запуску, доки команда не з’ясує, чи навчання перевіряльників на B змінить їхній підхід до A. Після цього план розподілу й аналіз потрібно визначити разом.
Коли коректність дизайну буде підтверджено, придатні одиниці випадково розподілятимуть між A та B протягом одного періоду порівняння, зберігаючи цей розподіл до завершення спостереження.
Визначте, що могли б обґрунтувати докази
До початку визначте основний результат, захисні показники, перевірки розподілу, правила аналізу й зупинки. Оцінюйте різницю разом із її невизначеністю. Сприятлива точкова оцінка може не давати достатніх підстав для рішення. Не оголошуйте переможця лише тому, що проміжний результат обнадіює.
Для цього вигаданого рішення команда мала б визначити, яке покращення є значущим і яку додаткову затримку перевірки вона готова прийняти. Перед тлумаченням порівняння також знадобиться пояснення відсутніх записів результату. Жодного з цих порогів тут не обрано: їх визначення — частина планування, а не результат, який можна вигадати.
Матеріал «Від AI-демонстрації до надійного робочого процесу» задає навколишній контракт входу й виходу та явно називає наступну відповідальну роль. Ці правила вимірювання додають вужче питання: який зафіксований результат обґрунтує зміну процесу? Доки визначення, порівняння й невизначеність не підтримують відповіді, «ми це виміряли» описує діяльність, а не доводить користі зміни.