Що таке AI-агент: практична архітектура за межами чатбота
14.10.2026
Виявлено, проскановано, проіндексовано: чому це різні стани
17.10.2026
Позначка «безкоштовно» — простий привід спробувати модель. Але у випадку Nemotron 3.5 Lightning на Vercel почати краще з умов, написаних дрібним шрифтом.
14 жовтня Vercel додав до AI Gateway модель, яку обслуговує NVIDIA. На її поточній сторінці зазначено: безкоштовний endpoint записує промпти й відповіді для вдосконалення продуктів і сервісів NVIDIA. Він призначений для пробного використання, а не для production чи критично важливих бізнес-систем. Користувачів прямо застерігають не надсилати персональну, конфіденційну або чутливу інформацію. Це значно конкретніше обмеження, ніж загальне попередження, що провайдер може зберігати дані.
Водночас за цією пропозицією стоїть цікава модель. Lightning орієнтована на повторювану роботу всередині агента: виклики інструментів, перевірку результатів і виконання чітко визначеної частини більшого завдання. Варто з’ясувати, яку частину цієї роботи вона здатна надійно виконувати, а не чи може замінити найсильнішу модель у кожній розмові.
Чому менша модель-виконавець може бути корисною
NVIDIA описує Lightning як модель з архітектурою mixture-of-experts (MoE, «суміш експертів») на 30 мільярдів параметрів, із яких для кожного токена активні приблизно три мільярди. Це важлива відмінність: коли працює менша частина моделі, на один крок потрібно менше обчислень. Але це не означає, що вся модель потребує стільки ж пам’яті, скільки звичайна модель на три мільярди параметрів.
Архітектура сімейства допомагає зрозуміти цей підхід. У представленні Nemotron 3 від NVIDIA за грудень 2025 року шари Mamba підтримують стан послідовності, шари attention пов’язують інформацію в різних частинах вхідних даних, а router обирає спеціалізованих експертів. Різні механізми виконують різні частини роботи — замість того, щоб кожен токен проходив той самий обчислювально витратний шлях.
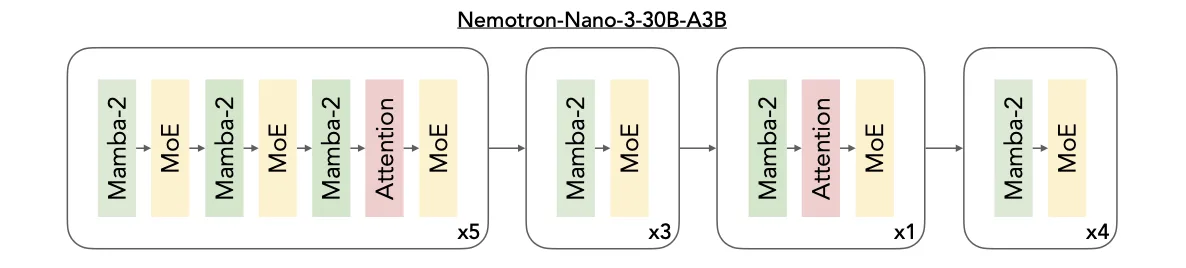
Ця давніша стаття дає контекст, але не є анонсом Lightning 3.5. NVIDIA представила Lightning у серпні 2026 року. В описі акцентовано виконання великої кількості завдань і multi-token prediction: попереднє формування кількох можливих наступних токенів та їхню ефективну перевірку. Швидше проходження рутинних кроків може скоротити час відгуку всього workflow — за умови, що перевірка й відновлення після збоїв і далі працюють.
Заявлене велике контекстне вікно не скасовує цього застереження. Vercel вказує місткість в один мільйон токенів, підтримку tool calling і structured outputs. Це підтримувані функції, а не доказ того, що модель знайде потрібний факт у довгому документі чи безпечно вирішить, як скористатися інструментом. Відповідь може бути коректним JSON і водночас містити хибний результат.
За корисними результатами стоять компроміси
Srimanth Tangedipalli та Karan Singh із LangChain перевірили споріднену ідею: починати роботу на Nemotron 3.5 Lightning і передавати її дорожчій моделі, коли модель-суддя виявляє проблему. У своєму серпневому дослідженні вони використали 145 контрольованих багатокрокових завдань, а не добірку вражаючих відповідей у чаті.
Система з маршрутизацією коштувала на 74% менше, ніж базовий варіант, у якому працювала лише frontier-модель, але точність знизилася з 86% до 80%. На модель-суддю припало 21,2% витрат системи з маршрутизацією. Інакше кажучи, саме рішення про те, коли залучати дорожчу модель, теж мало відчутну вартість. Це результати конкретного експерименту з платними моделями, а не прогноз для безкоштовного endpoint Vercel чи обіцянка економії на іншому навантаженні.
Для мене різниця в точності промовистіша за ефектну цифру економії. Шість відсоткових пунктів можуть бути прийнятними під час підготовки чернетки, зміни в якій можна скасувати, і неприйнятними у workflow, що змінює записи або надсилає повідомлення. Router потребує error budget — визначеного допустимого рівня помилок — і механізму зупинки. Дешевша модель-виконавець сама собою не забезпечує ні того, ні іншого.
Команда Thoughtworks, яка отримала ранній доступ, підійшла до моделі з іншого боку. Gustavo Lujan, Allen Roush та Andy Nolan описують її адаптацію до конкретних предметних областей і перевірку адаптованих версій на питаннях, відкладених для оцінювання, зі сліпим порівнянням відповідей. Вони також досліджували, як змінити манеру письма моделі, замість того щоб виправляти кожну відповідь додатковим промптом. Thoughtworks прямо називає себе партнером програми раннього доступу. Тому це корисний інженерний досвід із перших рук, а не незалежний висновок про будь-яке застосування моделі.
Мене тут цікавить метод: дати моделі вужче завдання, відокремити приклади для оцінювання від навчальних даних і перевірити, чи справді зміна допомагає. Якщо спеціалізована версія добре працює в оцінюванні однієї команди, це ще не робить загальнодоступний endpoint без такої адаптації експертом у цій предметній області.
Відкриті ваги й розміщений у провайдера endpoint — різні варіанти
У меню вибору моделі цю різницю легко не помітити. Відкриті ваги дають команді інший спосіб розгорнути й налаштувати модель. Безкоштовний доступ через провайдера дає змогу користуватися сервісом на його поточних умовах. Обираючи один варіант, ви не отримуєте автоматично засобів контролю даних, доступних в іншому.
Для конфіденційного внутрішнього корпусу документів це не другорядна деталь. Крім щойно введеного речення, промпт може містити знайдені фрагменти, вкладені файли й попередні повідомлення. Тому на перший погляд безпечне прохання стисло викласти документ може передати значно більше, ніж усвідомлює користувач. Такі матеріали не слід надсилати через цей безкоштовний endpoint.
Який тест варто провести
Я почав би з публічного анонсу й невеликого завдання: витягти дату запуску, умови доступності та адресу джерела. Потім додав би старіший анонс, який йому суперечить. Чи розрізнить модель дати, визначить, що змінилося, і відмовиться підміняти відсутній факт правдоподібним припущенням?
Це близько до реальної редакційної роботи, а результат легко перевірити. Той самий підхід можна застосувати до асистента з інструментами: почати з операцій лише для читання, перевірити аргументи викликів і включити до тесту невдалий результат роботи інструмента. Не варто давати моделі, яку лише випробовують, право публікувати тільки тому, що вона підготувала одну переконливу чернетку.
Для мене привабливість Nemotron — у можливості підібрати доречного виконавця для більшої системи. Безкоштовний доступ через Vercel полегшує таку перевірку. Він не робить будь-які вхідні дані допустимими, кожне завдання — безпечним, а сервіс — придатним для production. Ці рішення й далі має ухвалювати людина, яка будує workflow.
Джерела перевірено 15 жовтня 2026 року. Ця стаття — редакційна оцінка опублікованих специфікацій і матеріалів із перших рук, а не власний практичний benchmark endpoint Vercel.