Від цінної для бізнесу дії до виміряної конверсії
17.10.2026
Що відбувається між вашим промптом і відповіддю моделі?
17.10.2026
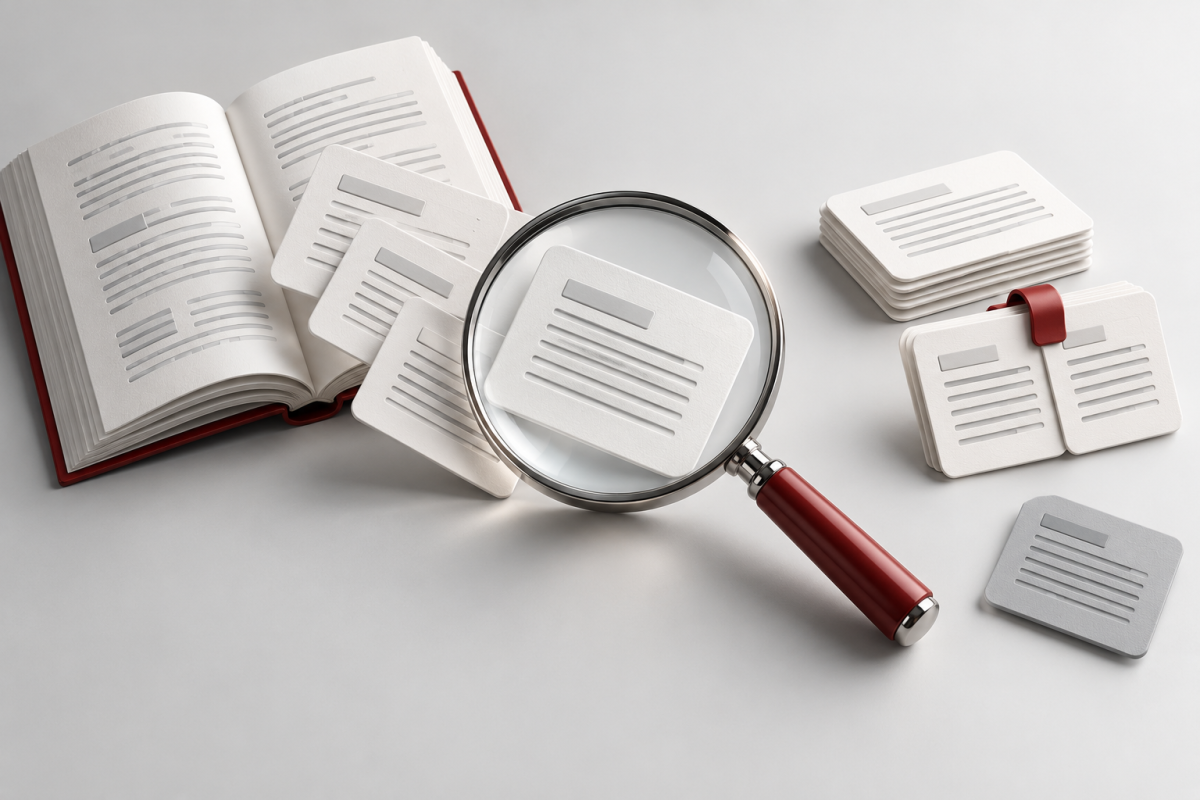
Від розмічених прикладів до запропонованої категорії. Ілюстрацію створено за допомогою AI.
Надходить звернення: «Мені потрібно перенести запис». Система пропонує передати його команді, яка займається записами. Звідки взялася ця пропозиція: із заданого правила, засвоєної закономірності чи згенерованого пояснення? Відповідь важлива, коли ми вирішуємо, що перевіряти та які дії дозволяти системі.
AI — це галузь, а машинне навчання — підхід
Штучний інтелект (artificial intelligence), або AI, охоплює технології для завдань, пов’язаних з інтелектом, зокрема розуміння мови та прогнозування. Машинне навчання (machine learning), або ML, — один із підходів у цій ширшій галузі. У порівнянні AI та ML від Google Cloud розмежовано їхній обсяг: ці терміни не позначають взаємозамінні продукти.
У машинному навчанні дані використовують, щоб навчити модель робити прогнози або генерувати контент. У навчанні з учителем приклади містять відповіді, які модель має навчитися передбачати. Класифікатор визначає категорію, а не обов’язково створює письмову відповідь.
Інструкція на кшталт «передавай усі форми з позначкою “запис” команді запису» може бути незмінним правилом. Сама її автоматизація не доводить навчання на прикладах. І навпаки: назва AI мало говорить про те, чи доречне конкретне рішення застосунку щодо передавання звернення. Перевіряйте, як завдання виконується насправді.
Визначте завдання моделі та значення даних
Набір даних (Dataset) — це сукупність даних. У завданні навчання розрізняйте приклади, використані для навчання, і приклади, відкладені для оцінювання. AI-модель (AI model) у значенні ML, про яке йдеться тут, поєднує засвоєні значення та структуру, щоб перетворювати подані вхідні дані на прогнози.
Розгляньмо один вигаданий класифікатор звернень. Його розробники задають три мітки напрямів: запис, оплата й технічна підтримка. Кожен навчальний приклад поєднує звернення з потрібним напрямом. Увесь сценарій ілюстративний: він не представляє реальних повідомлень клієнтів, розгорнутої моделі, проведеного навчання чи виміряного результату цього сайту.
Перш ніж збирати приклади, команді з цього сценарію потрібно погодити правила розмітки. Прохання перенести запис належить до напряму запису, а питання про рахунок — до оплати. Для повідомлення, що містить обидва питання, потрібен погоджений підхід. Це рішення визначає навчальне завдання; формат файлу з даними не може ухвалити його за команду.
Команда пропонує включити різні формулювання та випадки, які перевіряльники вважають неоднозначними. Вона також пропонує перевірити, чи послідовно мітки відповідають потрібним напрямам. Це заплановані перевірки, а не твердження, що вигаданий набір даних репрезентативний або що більший обсяг даних автоматично усуне його недоліки.
Навчання змінює засвоєні значення, а інференс застосовує їх
Параметр моделі (Model parameter) — це значення, засвоєне під час навчання, наприклад вага або зміщення. Навчання моделі (Model training) коригує ці значення на основі прикладів. Параметри відрізняються від звернення, поданого на вхід. У глосарії ML від Google застосування навченої моделі для отримання прогнозу названо інференсом.
| Частина вигаданої системи | Її роль у цьому прикладі | Що слід розмежовувати |
|---|---|---|
| Набір розмічених звернень | Надає приклади й потрібні напрями | Приклади та підтвердження успішної роботи |
| Етап навчання | Навчає модель виконувати задане завдання | Навчання моделі та опрацювання нового звернення |
| Навчений класифікатор | Пропонує напрям для нового звернення | Передбачену категорію та перевірене рішення |
| Застосунок навколо моделі | Показує пропозицію перевіряльнику | Вихід моделі та дозвіл передати звернення в роботу |
Припустімо, далі команда використовує для пропозицій фіксовану навчену версію. Нове звернення — це вхідні дані для цієї версії, а не новий параметр. У цій навмисно фіксованій конфігурації опрацювання звернення не оновлює засвоєних значень. Чи збирає інший застосунок зворотний зв’язок окремо й чи проводить повторне навчання — інше питання проєктування.
Тепер уявімо звернення, у якому водночас сказано «перенесіть мій запис» і «здається, у рахунку помилка». Класифікатор може запропонувати одну категорію, тоді як перевіряльник побачить два завдання. Команді з цього сценарію потрібно було б вирішити, як діяти за такої невідповідності. Вихід моделі — це пропозиція в межах визначеного завдання, а не доказ того, що звернення має лише одне правильне тлумачення.
Для оцінювання команда пропонує відкласти звернення, які не використовувалися для навчання моделі, та порівняти її пропозиції з перевіреними напрямами. Вона мала б розглянути помилки за категоріями й визначити, які з них потребують перевірки людиною. Поки цю роботу не виконано, приклад пояснює процес, але не підтверджує точності чи економії часу.
Кількість параметрів може характеризувати місткість моделі, але не доводить її якості для цього завдання розподілу звернень. Щоб стверджувати, що одна модель-кандидат краща за іншу, потрібні релевантні результати оцінювання. Відповідність набору даних завданню, навчена модель і її фактичне використання залишаються окремими питаннями.
Генерування відповіді — інше завдання
Генеративний AI (generative AI) створює контент на основі засвоєних закономірностей. Google Cloud описує такі результати, як текст, зображення та код. Ця здатність не визначає єдиної архітектури, а згенероване пояснення — інший тип результату, ніж мітка напряму. Обидва можуть бути частинами більшого AI-застосунку.
Вступний матеріал Google про ML охоплює і прогнозування, і генерування. Модель може віднести вхідні дані до категорії, а генеративна модель — створити на їхній основі контент. Відмінність стосується завдання та результату; сам інтерфейс чату не пояснює, яке навчання відбулося і яке оцінювання могло б підтвердити корисність.
Повернімося до того самого вигаданого звернення. Після того як перевіряльник визначить напрям, команда могла б доручити окремому генеративному компоненту підготувати чернетку відповіді. У ній можна запропонувати перенесення запису, але це не підтвердить, що будь-який запис справді перенесено. Для такої дії застосунку все одно потрібні перевірена інформація та належні повноваження.
Навіть природно написана чернетка не може надати відсутніх підтверджень щодо рахунку. У цьому сценарії доцільно перевірити, чи відповідає текст підтвердженим фактам і рішенню перевіряльника. Назва «генеративний» не усуває цієї потреби.
Аналізуючи AI-систему, з’ясуйте, які дані сформували завдання, яку навчену модель використовують, що вона отримує на вхід зараз і що відбувається після її відповіді. Ці питання пов’язують терміни з рішенням, яке можна перевірити, замість використовувати слово AI як готове пояснення.
Далі простежте, що відбувається між вашим промптом і відповіддю моделі, щоб пов’язати ці поняття з конкретними вхідними даними та запропонованою відповіддю.