Інструменти AI-агентів і MCP: як проєктувати безпечні для моделі інтерфейси
14.10.2026
Agent Skills: як пакувати повторно використовувані можливості без перевантаження контексту
14.10.2026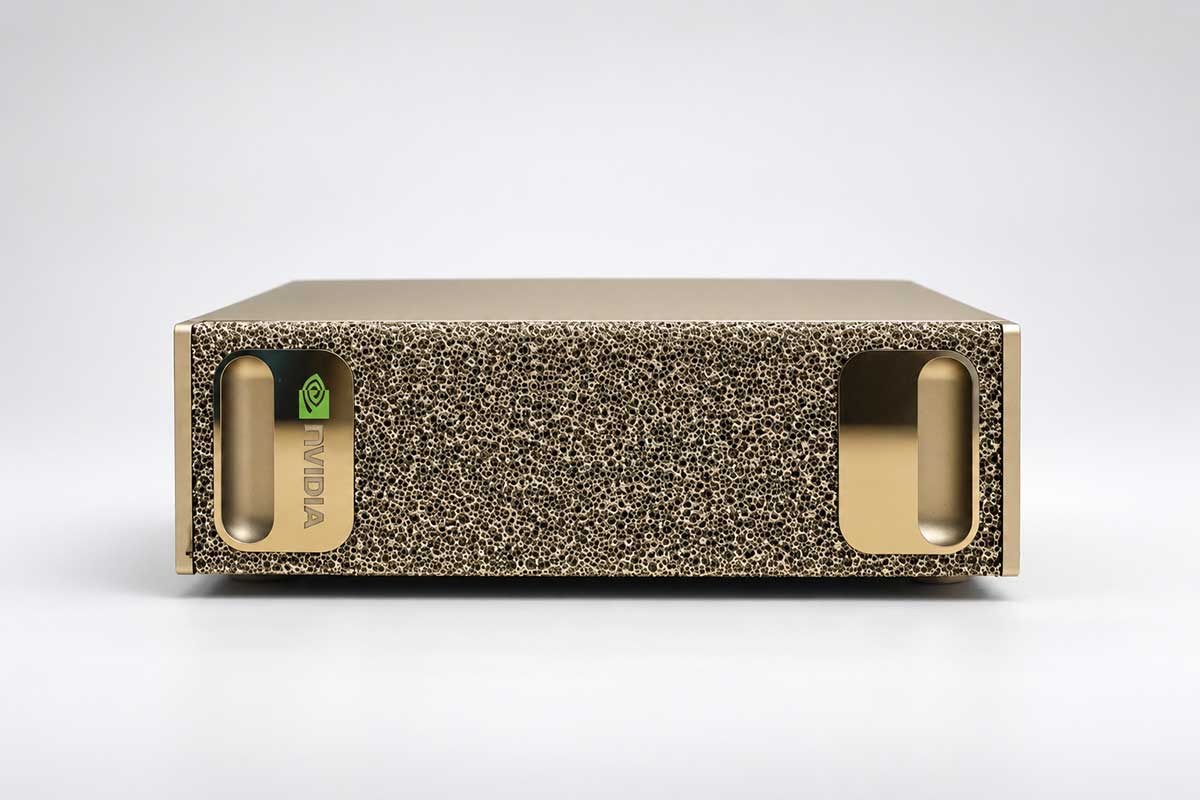
NVIDIA DGX Spark найпростіше розглядати як компактний спеціалізований пристрій для розробки AI. Це не звичайна Windows-станція і не заміна найшвидшому дискретному GPU, коли модель уже вміщується в його пам’яті. Привабливість DGX Spark — у поєднанні 128 GB когерентної об’єднаної пам’яті, програмного стека NVIDIA та надзвичайно швидкого мережевого з’єднання між вузлами в корпусі об’ємом 1.13 літра.
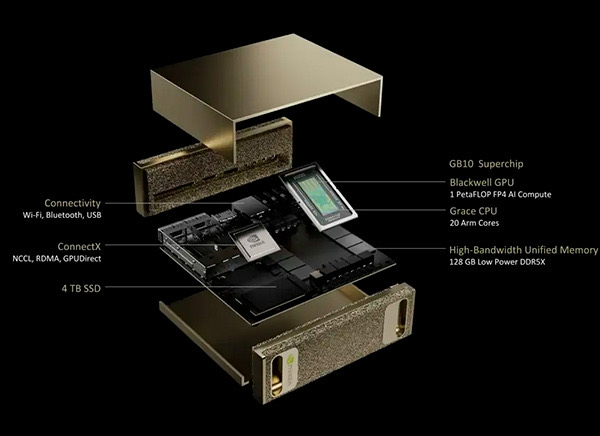
Модель на 4 TB використовує GB10 Grace Blackwell Superchip: 20-ядерний Arm CPU у парі з Blackwell GPU, Tensor Cores п’ятого покоління та тензорну продуктивність до 1 PFLOP у sparse FP4. NVIDIA зазначає пропускну здатність пам’яті 273 GB/s, самошифрувальний SSD NVMe M.2 на 4 TB, 10GbE, Wi-Fi 7 та інтерфейс ConnectX-7, здатний забезпечити з’єднання на 200 Gb/s. За заявою компанії, один пристрій може виконувати inference моделей до 200 мільярдів параметрів і fine-tuning моделей до 70 мільярдів параметрів. Це заяви про місткість, а не гарантія швидкої інтерактивної відповіді: чи вміститься модель і як швидко вона відповідатиме, як і раніше, визначають quantization, довжина контексту, KV cache, runtime і навантаження.
Ця відмінність пояснює характер продукту. Потужний настільний GPU може мати значно вищу пропускну здатність пам’яті й швидше генерувати результати для моделей, які вміщуються в його VRAM. DGX Spark натомість обмінює пікову швидкість на значно більший доступний обсяг пам’яті. Він корисний, коли розробнику потрібно локально досліджувати більші відкриті моделі, виконувати quantization або оцінювати їх, не передавати чутливі вхідні дані спільному хмарному сервісу чи відтворювати роботу в середовищі CUDA перед перенесенням на інфраструктуру NVIDIA в дата-центрі.
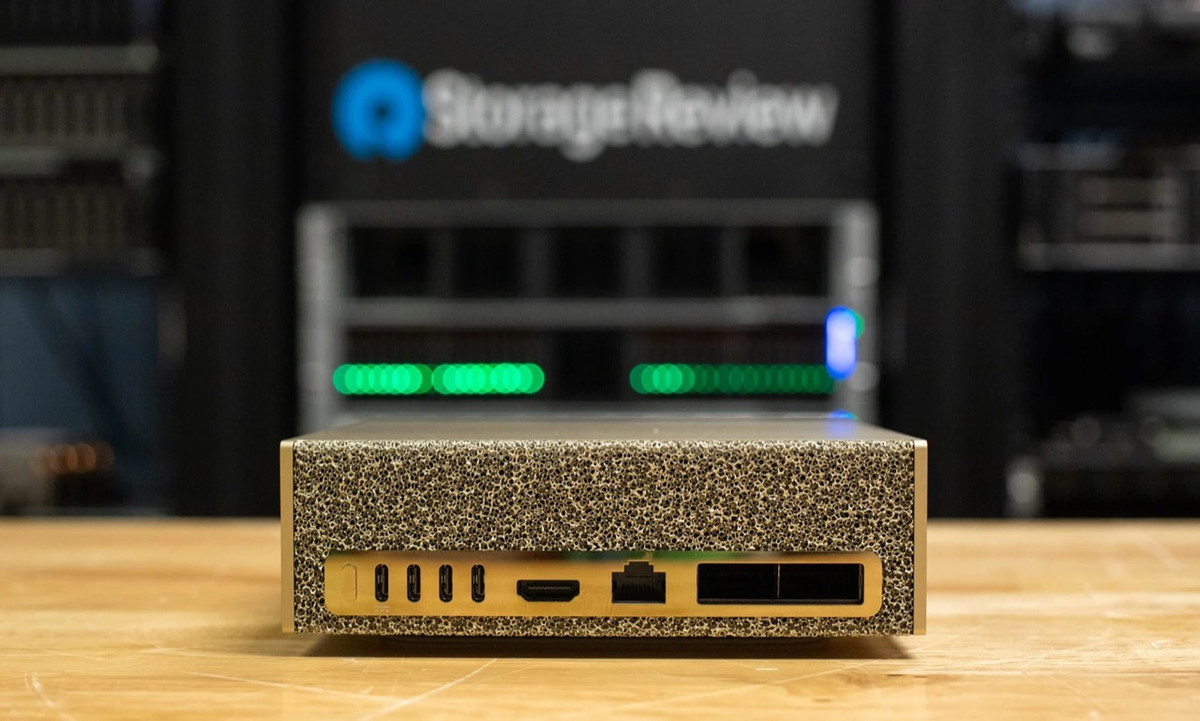
Незалежні тести додають необхідні застереження до основних характеристик. StorageReview описав корпус як компактний, щільно скомпонований і якісно зібраний, але також задокументував, що два фізичні інтерфейси QSFP не дають сумарної пропускної здатності 400 Gb/s. Через топологію платформа забезпечує максимум 200 Gb/s. Tom’s Hardware назвав спільну пропускну здатність пам’яті 273 GB/s головним обмеженням порівняно з дискретними GPU. Водночас оглядачі високо оцінили тиху роботу компактного пристрою, широкий набір інструментів AI та можливість з’єднати два вузли для навантажень, яким потрібен більший сукупний обсяг пам’яті.
Відгуки власників неоднозначніші. У спільнотах LocalLLaMA та NVIDIA хвалять можливість завантажувати великі моделі й попередньо налаштоване середовище CUDA. Інші дописи описують початкові труднощі з виведенням зображення, пакетами Arm і сумісністю фреймворків. Це окремі свідчення, які часто залежать від версії DGX OS, образу контейнера та прапорців runtime. Вони мають підказувати, що перевірити в тесті сумісності, а не слугувати універсальним висновком.
Економічна доцільність також змінилася. NVIDIA підтвердила, що в лютому 2026 року MSRP у США зросла з $3,999 до $4,699 через обмежену пропозицію пам’яті, без змін в обладнанні. За такої ціни DGX Spark має сенс для команд, які цінують 128 GB, CUDA та кластерне з’єднання на 200 Gb/s більше, ніж максимум токенів за секунду на витрачений долар. Його складніше виправдати для звичайної офісної роботи, ігор, невеликих моделей або навантажень, які вже ефективно виконує GPU з 24–32 GB пам’яті.
Перед купівлею протестуйте потрібні фреймворки й контейнери на Arm64, оцініть доступну пам’ять після врахування операційної системи та KV cache і порівняйте вартість хмарних альтернатив для очікуваного режиму використання. Зіставте близькі за платформою HP ZGX Nano, Acer Veriton GN100 і Dell Pro Max with GB10, а для рішення про купівлю скористайтеся порівнянням п’яти пристроїв.